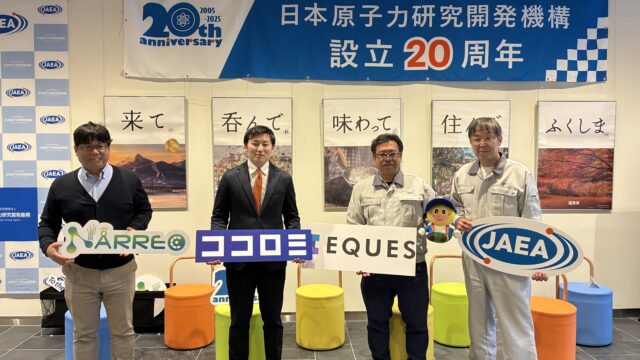
2026.11.04 農林水産省「AI×『農山漁村』インパクト創出ソリューション実装プログラム」採択のお知らせ ― 家畜防疫記録の効率化で自治体等の負担低減へ
助田 一晟 創業者&取締役 CTO、岸 尚希 創業者&代表取締役 CEO

Message

最先端の機械学習技術と
実務現場を結ぶ架け橋に

EQUESは、東京大学 松尾研発スタートアップとして、
最先端の機械学習技術と実務現場を結ぶ架け橋となることを目指しています。

研究開発の最前線で生まれる技術を、
実際の業務現場で活用可能な形に昇華させ、
社会の発展を加速させることが私たちのミッションです。

Read More

News

View All

Service

EQUESのサービス

創出力、価値変換力、スピード

EQUESは、高い専門性による創出力を、現場への価値変換力とスピードによって、
シームレスに産業へとつなげることを強みとしています。

Read More
伴走型技術開発

伴走型技術開発

お客様の課題に寄り添い、要件定義から運用まで一気通貫でサポート。最先端のAI技術を活用し、現場に最適化されたソリューションを提供します。

Read More

伴走型技術開発
サービス一覧

製薬AI事業

製薬AI事業

製薬業界における様々な業務課題を、生成AIによる技術開発や業務支援プロダクトによって解決します。

Read More

製薬AI事業
サービス一覧

エネルギーAI事業

エネルギーAI事業

持続可能なエネルギー稼働をAI開発でご支援します。フィジカルAIをはじめとする最先端技術を用いて、省人化、規制対応、リスク最小化を推進します。

Read More
量子AI事業

量子AI事業

AIによるデータ解析と、量子コンピューティングによる最適化を組み合わせ、創薬やエネルギーなど複雑な課題に挑みます。

Read More

取引実績

EQUESは多くの企業とパートナーシップを結んでいます。 ※一部抜粋

Example

お取引事例

View All

Member

メンバー

  • 岸 尚希 創業者&​代表取締役 CEO

    東京大学大学院.ex 松尾研プロジェクトマネジャー.
    松尾研起業クエスト1期生.
    松尾研チーフAIエンジニアとして企業との共同研究に従事.その後,現実世界と情報学の融合を志し,計数工学科在学時にEQUESを創業.専門はシステム情報学,特にテラヘルツ波通信とハプティクス(触覚技術).

  • 助田 一晟 創業者&取締役 CTO

    東京大学大学院. ex 松尾研プロジェクトマネジャー
    松尾研起業クエスト2期生.産総研「覚醒」事業採択.
    AIビジネスコンテスト全国優勝後,計数工学科で現CEO岸と出会いEQUESを創業.
    専門は数理情報学であり,クラスタリング最適化や医療AI分野の研究でトップジャーナルや国際会議に採択されている.

松尾 豊

Advisor

アドバイザー

松尾 豊

技術顧問

2007年より,東京大学大学院工学系研究科准教授. 2019年より教授. 専門分野は,人工知能,深層学習,ウェブマイニング. 人工知能学会からは論文賞(2002年),創立20周年記念事業賞(2006年),現場イノベーション賞(2011年),功労賞(2013年)の各賞を受賞. 2020-2022年,人工知能学会,情報処理学会理事. 2017年より日本ディープラーニング協会理事長. 2019年よりソフトバンクグループ社外取締役. 2021年より新しい資本主義実現会議 有識者構成員. 2023年よりAI戦略会議座長.

Column

コラム

AI導入の失敗事例6選|本番で止まる原因と防ぎ方【2026年】

AI導入の失敗事例6選|本番で止まる原因と防ぎ方【2026年】

2026.11.17

記事の要約 AI導入の失敗とは、ここではPoC(=本番開発前の小さな技術検証)で動いたAIが、本番移行や運用の段階で停止・廃止されることです。後の段階ほど影響は社外へ広がります。 原因が確認できる5件は、開発時のデータと本番の現実のずれ、予測の誤差を事業が吸収できないこと、誤った出力や不当な処理の責任を運用で負えないことの3つの型に整理できます。 防ぎ方は、本番条件での再評価、誤差の許容範囲と撤退条件、運用の責任者と停止手順を移行前に決め、対象を絞って段階的に広げることです。 「PoCでは十分な精度が出たのに、本番で使い始めたら苦情が相次いだ」。AI導入の失敗とは、本記事では、PoCでは動いたAIが、本番移行や運用の段階で止まる、または廃止されることです。 本記事では、本番移行と運用の段階で止まった失敗事例6件を、企業の発表や報道、学術誌、規制当局の処分から取り上げます。原因は確認できる範囲だけを扱い、自社の計画を点検できるよう、原因の型と防ぎ方を整理します。 東京大学松尾研発のAIスタートアップとして製薬・製造業のAI開発を手がける弊社の見方を交えて解説します。 AI導入の失敗はPoC・本番移行・運用の3段階で起こる AI導入の失敗は、PoC・本番移行・運用の段階ごとに性質が異なります。後の段階ほど、失敗の影響は大きくなります。 段階起きること影響が及ぶ範囲PoC判断材料が揃わず次に進めない検証の費用と期間本番移行検証時と本番の条件の違いで精度や採算が崩れる開発投資と展開計画運用誤った出力や不当な処理が利用者に届く顧客・法的責任・事業 影響が広がるのは、AIの出力を受け取る人が社外へ広がるからです。PoCの誤りは検証チームの中で止まりますが、運用中の誤りは顧客や市民に届きます。苦情や外部の指摘で見つかれば、訂正や補償、行政処分の対象になり得ます。 AIを導入・試験利用する国内企業のうち、効果が期待以上か期待どおりと答えたのは合計31.8%にとどまります(IPA『DX動向2026』)。最も多いのは「一定の効果はあった」の50.6%で、効果は出ていても期待には届かない企業が半数を占めます。 同じ調査では、運用上の課題として「適切な利用を管理するためのルールや基準の作成が難しい」が39.7%でした。ルールがないと、誤りが出ても誰が止めるかが決まらず、誤りが利用者に届き続けます。 海外でも、業務特化型の生成AIを検討した組織は60%、本番に至ったのは5%とする報告があります(MIT Project NANDA)。大半が本番に至っていないため、経営層が見るべき指標は、導入率より本番で使い続けられているかどうかです。 本記事が扱うのは本番移行と運用の段階で、PoC段階の失敗は「PoC失敗の事例5選|本番に進まない原因と防ぎ方【2026年】」で整理しています。 参照元:独立行政法人情報処理推進機構「DX動向2026」(2026年7月)/MIT Project NANDA「The GenAI Divide」(2025年7月) AI導入の失敗事例6選|本番移行と運用で止まったケース 本番移行と運用で止まった、または問題が明らかになった事例は、Amazonの採用AI、マクドナルドの音声注文、Epic Systemsの敗血症予測、Zillowの住宅買取、ニューヨーク市のチャットボット、オランダ税務当局のリスク判定の6件です。 原因は、当事者の発表・学術論文・規制当局の判断・報道で確認できる範囲だけを書き、理由が非公表の事例はその旨を明記します。 弊社の整理では、前半の2件が本番移行、後半の4件が運用の段階です。前半は「学習や検証に使ったデータは本番の対象と同じか」、後半は「誤りが届いたとき誰が止めるのか」を自社に問うと、計画の点検に使えます。 1. Amazon:性別に偏った採用AIを修正しきれず開発チームを解散 Amazonは2014年から履歴書を採点するAIを開発していましたが、技術職の候補者を性別に中立に評価できていないことが判明しました。学習に使った過去10年分の応募書類の大半が、男性からのものだったためです。 同社は特定の語に左右されないようプログラムを直しましたが、別の方法で偏った選別をしない保証はなく、経営陣が計画に見切りをつけて2017年初めまでにチームを解散したとされます(ロイター)。Amazonはこのツールについてコメントしていません。 2. マクドナルド:100店舗超で試したIBMとのAI音声注文の提携を終了 マクドナルドは2021年からIBMとAI音声注文を試験導入し、100店舗超のドライブスルーで運用していました。2024年6月、加盟店向けの文書で、試験店舗の運用を7月26日までに停止すると伝えています。 この文書が挙げた理由は「音声注文の解決策をより広く探る」ことで、終了の具体的な原因は明らかにされていません。約3年、100店舗超で試しても全店展開に進まなかった事実は、試験の規模と本番移行の判断は別物だと示しています。 3. Epic Systems:数百の病院が使う敗血症予測AIが外部検証で精度不足 Epic Systemsの敗血症予測モデルは、数百の米国病院で使われていた運用中のAIです。ミシガン大学の外部検証では、AUC(=上限は1で、当て推量でも0.5になる判別性能の指標)が0.63で、開発元が示す0.76〜0.83を下回りました。 アラートは入院患者の約18%に出る一方、敗血症患者の67%を検知できず、現場に大きなアラート疲れを生むと論文は指摘しています。警告が多いのに見逃しも多いと、現場は警告に反応しなくなります。 研究者は、差の一因を発症時点の扱いの違いに求めています。一般に、いつの予測を数えるかで精度は変わるため、開発元の数字は自社の条件で測り直します。 4. Zillow:住宅価格の予測誤差を吸収できず住宅買取事業から撤退 Zillowは、住宅価格の予測にもとづいて住宅を買い取り、再販する事業を運営していました。2021年第3四半期には、将来の販売価格の見込みを上回る価格で買い取った在庫について、約3億400万ドルの評価減を計上しています。 同社は2021年11月に事業の撤退と従業員の約25%の削減を発表しました。CEOは住宅価格の予測の不確実性が想定をはるかに上回ったと説明し、事業を拡大すると収益と財務の変動が大きくなりすぎると判断しています。 5. ニューヨーク市:法律に反する助言を返した事業者向けチャットボットを停止 ニューヨーク市は2023年秋、市の規則を案内する事業者向けの生成AIチャットボットを公開しました。2024年3月の報道で、雇用主が従業員のチップの一部を取れるなど、法律に反する回答が見つかっています。 市は免責表示を加えて運用を続け、答える質問の範囲も絞ったとみられます。2026年1月、新市長は「機能的に使えない」うえ費用もかかるとして停止を表明し、現在のページはベータテストの終了を告げています。 生成AIの誤回答の例は「ハルシネーションの事例7選|企業・団体で起きた原因3型と対策」で紹介しています。 6. オランダ税務当局:国籍データを使ったリスク判定に制裁金275万ユーロ オランダ税務当局は、保育手当の申請者が不正の「リスク」になるかを調べる処理で、二重国籍のデータをアルゴリズムで扱っていました。2014年に消去すべきデータが、2018年時点で約140万人分残っていました。 同国のデータ保護当局は2021年12月、この処理を違法かつ差別的と判断し、275万ユーロの制裁金を科しました。長官は、制裁金で被害を元に戻せるものではないとコメントしています。 この種の処理では、消す期限と点検の担当を決めない限り、使ってはならないデータは残り続けます。 参照元:CNBC(Reuters配信)「Amazon採用AIの廃止」(2018年10月)/NBC News「マクドナルドのAI注文テスト終了」(2024年6月)/JAMA Internal Medicine「敗血症予測モデルの外部検証」(2021年6月)/Zillow Group「2021年第3四半期決算とZillow Offers撤退」(2021年11月)/The Markup「市のAIチャットボットの誤回答」(2024年3月)、「チャットボットの停止」(2026年1月)/ニューヨーク市「NYC Chatbot」/NOS「税務当局への制裁金」(2021年12月) 本番で止まる原因は3つの型に分かれる 弊社の整理では、原因が確認できる5件は、データと評価のずれ、事業が吸収できない誤差、責任と統制の不足の3つの型に分かれます。いずれも、PoCの精度だけを見ていると見落とす論点です。 第1の型:Amazon、Epic 第2の型:Zillow 第3の型:ニューヨーク市、オランダ 第1の型は、開発時のデータや評価が本番の現実とずれることです。AmazonのAIは過去の偏りを学び、Epicのモデルは外部の病院で開発元の精度を再現できませんでした。 学習データ(=AIに判断の仕方を覚えさせるためのデータ)が一部の時期や現場に偏ると、本番では学習時になかった傾向のデータが増え、同じ精度は出にくくなります。製造の現場なら、特定ラインの画像だけで作った検査AIを全ラインへ広げる場面です。 第2の型は、予測の誤差を事業が吸収できないことです。Zillowは、事業を拡大すると収益と財務の変動が大きくなりすぎると判断しました。この型では、予測が外れるたびに損失が出るため、件数を増やすほど損失の合計も膨らみます。 第3の型は、誤った出力や不当な処理の責任を運用で負えないことです。弊社の整理でこの型に入れたニューヨーク市は、免責表示を加えて運用を続けましたが、2026年1月に新市長が「機能的に使えない」ことと費用を理由に停止を表明しました。オランダ税務当局では、消すべきデータが判定の処理に残りました。 一般に、免責表示は責任の所在を示すだけで、誤った回答は減らしません。利用者は回答を前提に動くため、誤りはそのまま損失になります。 問題が見つかった後の対応は、事例では中止、継続後の停止、撤退に分かれました。誤りが顧客や法令に関わるなら、続ける間も誤りが届くため、まず止めます。再発を防げる見通しが立てば範囲を絞って再開し、損失を事業が吸収できないなら撤退を選びます。 本番で止めないための防ぎ方|移行前に決める4つのこと 本番で止めないための防ぎ方は、弊社の見方では、本番条件での再評価、誤差の許容範囲と撤退条件、運用の責任者と停止手順、段階的な展開の4点を本番移行の前に決めることです。 第1に、本番と同じ条件のデータで再評価することです。対象期間・拠点・入力形式を本番に合わせて精度を測り直します。この工程を飛ばすと、開発元の数字と現場の実感が食い違ったまま運用が続きます。 第2に、誤差の許容範囲と撤退条件を事業の数字で決めることです。誤り1件の損失と想定件数から許容できる誤差を逆算し、超えたら止める条件を文書にします。文書がないと、問題が出た後は投じた費用を惜しんで、止める判断が遅れます。 指標の決め方は「PoC評価指標の決め方|成功基準・KPI例と3層モデル2026」で解説しています。 第3に、運用の責任者・監視・停止手順を決めることです。出力を点検する人と、止める決定をする人を、それぞれ名前で決めます。止める権限を持つ人が決まっていないと、誤りに気づいても運用が続きます。 どの兆候で止めるかも、運用ルールとして文書にします。例は、利用者や外部からの誤りの指摘、開発時の数字と現場の実感の食い違い、使ってはならない属性のデータの混入です。 第4に、範囲を絞って始め、段階的に広げることです。一度に全社展開すると誤りの影響も一度に広がりますが、対象を限定すれば小さく抑えられます。 ロート製薬株式会社(品質統括部)は、全面自動化は現実的でないと判断し、「まずは30〜40%でも業務効率化」を目指す発想に切り替えました。製品スペック(仕様書)作成の自動化から、生成AI活用を始めています。弊社のAI×DX寺子屋でスモールスタートを切り、手応えを感じている段階です。 弊社はAI PoCサービス「ココロミ」で、PoCの計画づくりから評価、次の段階のロードマップ策定までを支援しています。 社内に相談できる専門家がいない段階では、AI・DXの困りごとをチャットで相談できる「AI×DX寺子屋」もご利用いただけます。 参照元:株式会社EQUES「ロート製薬株式会社 導入事例」 ココロミ の詳細はこちら 本番移行前に確認するチェックリスト 防ぎ方の4点を、本番移行の承認前の確認項目にします。1つでも空欄があれば、承認を保留して埋めることをおすすめします。かっこ内は、空欄のまま進めると起きることです。 本番と同じ条件のデータで精度を測り直したか(検証時の数字が現場で出ない) 学習データに過去の偏りや、使ってはならない属性が含まれていないか(偏った判定が繰り返される) 誤り1件の損失と想定件数から、許容できる誤差を試算したか(損失が膨らんでも気づけない) 撤退条件を数値で文書化し、経営層と現場が合意しているか(止める判断が遅れる) 出力を点検する責任者と、停止を決める権限者が決まっているか(誤りに気づいても止まらない) 対象業務と利用者を限定した段階的な展開計画か(誤りの影響が一度に広がる) 判断材料を経営層に伝える構成は「PoC報告書の書き方|経営判断に使える7項目の構成とテンプレート」が参考になります。 AI導入の失敗に関するよくある質問 Q. PoCで精度が出たAIが、本番で精度を落とすのはなぜですか? PoCと本番で、入ってくるデータの条件が違うためです。本番と同じ条件のデータで測り直してから展開します。 Q. 生成AIのチャットボットは、免責表示を出せば運用を続けられますか? 免責表示は誤った回答を減らさないため、それだけでは続けられません。回答範囲の限定や人による確認を組み合わせます。 Q. 経営層は本番移行の承認で何を確認すべきですか? 精度の数字に加え、本番条件での評価結果、誤差による損失の試算と撤退条件、運用の責任者と停止手順、段階的な展開計画の4点です。 まとめ PoCを通過したAIも、本番移行や運用の段階で止まることがあります。要点は次のとおりです。 AI導入の失敗は3段階で起こり、後の段階ほど影響が社外に広がる 原因が確認できる5件は、3つの型に整理できる 本番条件での再評価、撤退条件、運用の責任者と停止手順、段階的な展開の4点で防ぐ 本番移行の計画を見直したい段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。 AI導入を本番で止めないために、PoCから相談しませんか AI PoCサービス「ココロミ」はスリムプラン月々99万円〜・スタンダードプラン月々250万円〜の月額制です。まずは無料相談からどうぞ。 無料で相談する ココロミを見る

再エネ出力予測AIの仕組みと事例4選|精度の見方とデータ要件

再エネ出力予測AIの仕組みと事例4選|精度の見方とデータ要件

2026.11.17

記事の要約 再エネの出力予測AIとは、気象予報と過去の発電実績を機械学習で結び、太陽光・風力の発電量を30分単位で見積もる仕組みです。 精度は平均的な誤差(RMSE・MAE)と、まれな「大外し」を分けて見ます。調整力(=需給のずれを埋める予備の電源など)の確保量は大外しの側で決まるためです。 公表事例では、アンサンブル予報の活用で調整力の必要量が2023年度に約28%減り、機械学習による補正で日射量予測の大外しが全日で13%(信頼度が高い日は23%)減りました。 再エネの出力予測AIとは、気象予報から太陽光・風力の発電量を事前に見積もるAIです。「FIPに移行してから、発電計画のずれが収支に直接響くようになった」。発電事業者が導入を検討し始めるのは、こうした場面です。 本記事では、予測が必要な理由、仕組み、精度指標の読み方、公表事例4件、導入の進め方を解説します。 OCCTO・NEDO・気象庁の公表資料をもとに、東京大学松尾研発のAIスタートアップとして製薬・製造業・エネルギー分野のAI開発を手がける弊社の視点で整理しました。 再エネの出力予測が必要な理由|インバランスと調整力のコスト 再エネの出力予測が必要なのは、発電計画と実績のずれが費用として精算されるためです。このずれをインバランスと呼び、一般送配電事業者が差分を補給します(九州電力送配電)。発電事業者はインバランス料金を精算することになり、費用負担が生じます(東芝)。 FIP制度(=市場価格に一定の上乗せをする再エネ支援制度)などで市場に売電する発電事業者は、前日の予測で翌日の発電計画を作り、前日の市場(スポット)で売ります。 当日に予報が変われば当日の市場(時間前)で差分を売買し、ゲートクローズ(=実需給前の計画の締め切り)で残ったずれがインバランスになります。前日と当日のどちらの予測を改善するかで、見る誤差も変わります。 一方、FIT特例の電源では、一般送配電事業者が前日に出力を予測し、その値が発電計画になります(OCCTO)。 社会全体でも、再エネの変動に備える調整力の調達コストは2025年度見込みで300億円程度です(NEDO)。予測誤差を減らせば確保する調整力も減るため、国と送配電事業者も精度向上に取り組んでいます。 発電事業者の判断基準は、予測の改善で減るインバランス費用が予測の費用を上回るかです。 需要側の予測は「需要予測AIの仕組みと活用事例5選|導入が失敗する3つの壁」で解説しています。 参照元:九州電力送配電「主な見直し内容(別紙)」(2022年3月)/電力広域的運営推進機関「再エネ予測精度向上に向けた取り組みについて」(2024年11月)/東芝「気象予測とAI技術で風車付近の地形効果を考慮した高精度な風力発電量予測技術を開発」(2024年5月)、「再エネアグリゲーションの解説」/NEDO「日射量予測の“大外し”低減技術を開発しました」(2025年10月) 出力予測AIの仕組み|数値気象予報と機械学習の2段構成 再エネの出力予測AIは、気象を予測する段と、気象を発電量に変換する段の2段で構成する例が多く見られます。機械学習は主に後段と、気象予報の誤差補正に使われます。 誤差がどちらの段で生じているかを見分けると、気象予報を替えるべきか、変換モデルを学習し直すべきかを判断でき、改善にかかる費用も見積もりやすくなります。 気象予報から発電量へ変換する流れ 前段は数値気象予報(=大気の動きを計算して出す予報)で日射量や風速を出し、後段はそれを発電量に変換します。 前段の予報には初期値(=計算の出発点とする大気の状態)の誤差やモデルの不完全さが含まれ、予報時間が長くなるほど誤差は増大します(気象庁)。翌日・翌々日の予測が大きく外れる日が出るのはこのためです。 後段の風力では、風車ごとの風速と出力の関係(パワーカーブ)をAIが学習し、地形による風速のずれも補正します(東芝)。 同じ予報値でも、設備の向きや機種で発電量は変わります。そのため、自社で予測モデルを持つ場合は、変換部分は自社の発電実績で学習させる必要があり、気象会社の日射量予測をそのまま発電計画には使えません。 アンサンブル予報で外れやすい日を前日に知る アンサンブル予報からは、翌日の予測が外れやすいかが前日に分かります。初期値を少しずつ変えた複数の数値気象予報から、予測とその不確実性を推定する手法で(気象庁)、予報同士のばらつきが大きい日は信頼度が低いと判断できます。 信頼度が高い日は調整力や売電量の余裕を小さく、低い日は大きく取る、という使い方があります。追加の調達や入札の準備も前倒しできます。 予測サービスを選ぶときは、予測値1本ではなく外れる幅も受け取れるかを確認します。予測値しか出ない仕組みでは、外れた日の損失を事前に見積もれません。 参照元:気象庁「令和7年度数値予報解説資料集 1.5 アンサンブル予報」(2025年度)/東芝「気象予測とAI技術で風車付近の地形効果を考慮した高精度な風力発電量予測技術を開発」(2024年5月) 予測精度の見方|RMSE・MAE・誤差率と「大外し」 予測精度は、平均的な外れ方と、まれな大きな外れを分けて評価します。平均の指標だけでは、収支を大きく動かす日の誤差が見えないためです。 指標定義読み取れることRMSE(二乗平均平方根誤差)誤差を2乗して平均し、平方根をとった値誤差の標準的な大きさMAE(平均絶対誤差)誤差の絶対値を平均した値平均的な外れ幅誤差率(%)誤差を定格容量などで割った値規模の違う設備の比較3σ相当誤差誤差実績の約99.87%をカバーする値まれな大外しの大きさ RMSEは誤差を2乗するため大きな外れを重く数え、MAE以上の値になります(RMSEの定義は気象庁の用語に準拠)。両者の差が開くほど、大きく外れた日が混ざっていると読めます。 誤差率は分母を確かめてから比べる必要があります。東芝エネルギーシステムズらの実証は、30分ごとの予測と実績の差を定格容量で割っています。発電量の実績で割る方式より、同じ外れでも数値は小さく出ます。 調整力の確保量は大外しで決まります。送配電事業者は過去2年分の誤差実績から、過去最大相当の3σ相当値で必要量を算出してきました。2024年7月からは、前日の市場では誤差実績の約84%をカバーする1σ相当を調達し、大きく下振れしそうな場合だけ追加で調達する運用に変わっています(OCCTO)。 複数のベンダーを比べるときは、指標の定義・分母・評価期間を揃えることが前提です。 検証の指標の決め方は「PoC評価指標の決め方|成功基準・KPI例と3層モデル2026」も参考になります。 参照元:気象庁「予報の評価に関する用語」/電力広域的運営推進機関「再エネ予測精度向上に向けた取り組みについて」(2024年11月) 再エネ出力予測AIの事例4選|送配電・研究機関・メーカー・気象会社 公表資料で確認できた4件を、課題と変えた点に注目して紹介します。自社の課題が「平均の精度」なら事例3、「大外し」なら事例2、「外れ幅の把握」なら事例1・4が参考になります。 平均の誤差を下げても、大きく外れる日があれば損失は残ります。課題がどれに当たるかを先に決めると、自社に合う手法を判断しやすくなります。 1. 一般送配電事業者:アンサンブル予報で日射量予測の信頼度を2段階に分け、全エリアで調整力の必要量を2023年度に導入前比で年間約28%低減 送配電事業者は、再エネの予測誤差に備える調整力の量を、過去2年分の誤差から作る必要量テーブルで決め、前日に調達しています。課題は、誤差の小さい日も大きい日と同じ量を確保していたことでした。 気象会社がアンサンブル予報から日射量の信頼度を「高・低」で出し、日ごとにテーブルを使い分ける方式に変えました。2023年4月に全エリアへ導入し、2023年度の必要量は導入前より年間で約28%減ったと報告されています。 1σ相当の調達に変わった後は、削減効果は全国計で約8%に縮小し、北陸エリアでは実施を見合わせています。 2. NEDO・日本気象協会・産総研:複数の気象モデルを統合して機械学習で補正し、日射量予測の大外しを従来手法比で全日13%・高信頼度の日23%低減 NEDO事業(2021〜2024年度)の課題は、翌日・翌々日の日射量予測が大きく外れることでした。日本気象協会が予測手法を開発し、産総研が気象庁データで大外しの要因を分析しています。 頻度の少ない大外しに絞って機械学習で補正した結果、信頼度が高いと予測した日の大外しは従来比23%、全日では13%減りました。同協会の予測サービスには、2026年秋ごろから実装する予定と発表されています(2025年10月時点)。 3. 東芝エネルギーシステムズ:地形を考慮した気象予測と風速補正AIで、風力の前日予測誤差を前年度の実証の17.3%から10.1%に改善 東芝エネルギーシステムズらは、アグリゲーター8社などのコンソーシアムで全国約100のリソースを使い実証しました。既存技術を使った前年度の実証では、風力の誤差が17.3%と太陽光の3.5%を大きく上回ったことが課題でした。 地形を考慮した気象予測、風向に応じた風速補正AI、風車ごとのパワーカーブ学習を組み合わせ(東芝)、前日朝の平均誤差を10.1%に下げました。評価は2023年12月〜2024年1月を中心とする期間で、前年度と同じ条件での比較ではありません。太陽光は2.9%で、いずれも定格容量で割った値です。 4. ウェザーニューズ:過去数年分の気象条件と発電量の分布をAIが学習し、発電量が収まる範囲を確率で示す予測区間データを追加 ウェザーニューズは2026年10月、太陽光・風力の発電量予測に「予測区間データ」を加えました。背景は、1本の予測値では不確実性を把握できず、計画やヘッジの検討が難しかったことです。 AIは学習した発電量の分布に、最新の気象予測の幅も加味します。想定用途には非FIT発電所のインバランスリスク低減が挙がり、精度の数値は公表されていません。 予測を発電計画や蓄電池運用の意思決定につなぐ方法は「数理最適化の事例8選|ビジネスでの使い方とAIとの組み合わせ」で整理しています。 参照元:電力広域的運営推進機関「再エネ予測精度向上に向けた取り組みについて」(2024年11月)/NEDO「日射量予測の“大外し”低減技術を開発しました」(2025年10月)/東芝エネルギーシステムズ「複数電力市場での取引戦略の活用により2.3倍以上の収益改善を実証」(2024年3月)/東芝「気象予測とAI技術で風車付近の地形効果を考慮した高精度な風力発電量予測技術を開発」(2024年5月)/ウェザーニューズ「太陽光・風力発電量予測がさらに強化中」(2026年10月) 事業で使うときのデータ要件と導入の進め方 出力予測AIの導入は、データを集める前に、予測の用途を決めることから始めます。用途で見るべき指標も、データの細かさも変わるためです。 必要なデータは、学習の正解になる30分単位の発電実績、入力になる同じ時刻の気象予報値、誤差率の分母を揃える定格容量や、設置場所などの設備情報です。 気象データは、観測値ではなく当時の予報値を残します。運用時にモデルへ入るのは予報値なので、観測値で学習すると予報の外れ方を学べず、本番で誤差が増えます。 ステップやること飛ばすと起きること1. 用途と指標を決める売電計画ならMAEとインバランス費用、調整力なら3σ相当誤差で合格ラインを置くRMSEは改善したのに収支が変わらない2. データを揃える発電実績に、出力制御や点検停止の時間帯の印を付ける停止中の「発電しない晴天」をAIが学習する3. 既存予測と比べる同じ期間・指標で比べ、改善をインバランス費用に換算する投資判断の材料が揃わない4. 運用で学び続ける実績との差を記録して再学習し、精度低下時の判断者を決める設備の増設や劣化による精度低下に気づかない データの期間は、季節を一巡する1年分以上が弊社の目安で、梅雨や冬の季節風など外れやすい時期を評価期間に含めます。 PoC(=本番開発の前に小さく行う技術検証)の目的と期間の決め方は「AI PoCの進め方とは?期間や失敗しない秘訣を事例と共に解説」で解説しています。 このように、導入は用途と指標を決めた検証から始まります。弊社のAI PoCサービス「ココロミ」(スリムプラン月々99万円〜・スタンダードプラン月々250万円〜)では、再エネ事業者のデータを使った出力予測のPoCをご相談いただけます。 エネルギー分野では、経済産業省の廃炉関連の補助事業でフィジカルAIのデータ処理基盤を担当するほか、電力会社での生成AI研修・研究の支援実績があります(東北電力の1Day研修、部門専用スライド生成AIの研究)。 ココロミ の詳細はこちら 再エネ出力予測AIに関するよくある質問 Q. 太陽光と風力では、どちらの出力予測が難しいですか? 東芝エネルギーシステムズらの実証では風力のほうが難しく、前日予測の平均誤差は太陽光2.9%、風力10.1%でした。風力は風速で出力が大きく変わるためです(東芝)。 Q. 気象会社の予測サービスと自社でのAI開発は、どう使い分けますか? 自社で予測モデルを持つ場合は、気象予報は気象会社から受け取り、発電量への変換と補正だけを自社データで学習させるのが現実的です。数値気象予報の自社運用は負担が大きいためです。 Q. 工場や公共施設の屋根に置く自家消費型の太陽光でも、出力予測は必要ですか? 余剰を売電するなら必要です。売電の計画に載せるのは発電量から施設の使用電力を引いた余剰量なので、発電量に加えて電力需要の予測も要ります(BIPROGY「太陽光発電量・余剰量予測サービス」)。 Q. 発電所が1か所だけでも出力予測AIは使えますか? 使えます。変換部分は発電所ごとの発電実績で学習するためです。実績が1年分に満たない発電所では、設備仕様から発電量を計算する工学モデルで始め、実績がたまったら学習に加えます(東芝)。 まとめ 再エネの出力予測AIは、インバランスと調整力の費用を減らすための仕組みです。 計画と実績のずれはインバランスとして精算され、市場で売電する発電事業者の費用負担になる 精度はRMSE・MAEの平均的な誤差と、調整力の確保量を決める大外しを分けて評価する 公表事例では、アンサンブル予報や機械学習の補正で調整力の必要量や大外しが減っている 自社データでの予測の検証を検討する段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。 再エネ出力予測の精度を、自社データで検証しませんか AI PoCサービス「ココロミ」はスリムプラン月々99万円〜・スタンダードプラン月々250万円〜の月額制です。まずは無料相談からどうぞ。 無料で相談する ココロミを見る

予知保全AIの事例5選|異常検知との違いと必要なデータ・始め方

予知保全AIの事例5選|異常検知との違いと必要なデータ・始め方

2026.11.17

記事の要約 予知保全とは、設備の状態データから故障の兆候をつかみ、壊れる前の適切な時期に保全する方式で、異常検知はそれを支える手段の一つです。 公表事例では、デンカ青海工場でライン全体を止める回転機械の重大トラブルが年20件から11件に減るなど、効果はトラブル件数や検査時間で示されています。 始め方は、停止損失が大きく兆候を測れる設備を1種類選び、導入前の停止件数と点検時間を実測したうえで、検知後の判断と作業指示まで含めて小さく試すことです。 予知保全とは、振動や温度などのデータから設備の故障の兆候をつかみ、壊れる前に保全する方式です。予兆保全とも呼ばれます。「突発停止のたびに夜間の呼び出しがかかる」現場の悩みに応えます。 本記事では、予知保全AIの事例を企業の公式発表とNEDOの資料から5件取り上げ、異常検知との違い、必要なデータとセンサ、効果の目安を整理します。 東京大学松尾研発のAIスタートアップとして製造業・エネルギー分野のAI開発を手がける弊社の視点も交えて解説します。 予知保全とは?予防保全・事後保全との違い 予知保全とは、設備の状態データから故障の兆候をつかみ、壊れる前に保全する方式です。状態に応じて保全の時期を決めるため、状態基準保全(CBM)とも呼ばれます。 保全の方式は、手を入れる時期の決め方で3つに分かれます。JIS Z 8115の用語では、状態を見て行う保全も予防保全の一種に分類されます。本記事では分かりやすさのため、時間基準を予防保全、状態基準を予知保全と呼び分けます。 方式時期の決め方向く設備弱点事後保全故障してから修理する止まっても影響が小さい設備突発停止と緊急対応が起きる予防保全(時間基準)稼働時間や期間で定期的に点検・交換する劣化が安定した設備、法定点検過剰な交換と、周期の間の故障予知保全(状態基準)振動・温度などのデータで兆候を検知して決める止まると損失が大きい設備センサと判断ルールの整備が要る 時間基準で時期がずれるのは、同じ型式でも劣化の速さが負荷や環境で変わるためです。周期を短くすれば過剰な交換が増え、長くすれば周期の間に壊れる設備が出てきます。 現場では「点検では異常なしだったのに翌週に軸受が焼き付いた」「交換した部品にほとんど摩耗がなかった」という形で表れます。 ただし、全設備を予知保全に切り替える必要はありません。影響の小さい設備は事後保全、法定点検は時間基準のまま残し、停止損失の大きい設備から状態基準に移すのが現実的です。 予知保全と異常検知の違い|異常検知は手段、予知保全は運用 予知保全と異常検知は、目的と手段の関係にあります。異常検知は「いつもと違う」を見つける手段で、予知保全はその結果で保全の時期と内容を決める運用です。 弊社の整理では、予知保全はデータの収集、異常の検知、原因の診断、残り寿命の見積もり、保全計画への反映という順に進みます。異常検知はこの2段目にあたり、検知だけでは保全のやり方は変わりません。 従来のしきい値監視は、1つの値が上限を超えたら知らせます。運転条件で正常値が動く設備では上限を高めに取るため、超えた時点では劣化が進んでいます。 AI(機械学習)は正常時の複数の値の関係を学習し、どの値も上限内でも関係が崩れた段階で知らせます。1つの値で兆候が読める設備はしきい値監視で足り、AIは複数の値を見る設備に使います。 検知だけを導入した現場では、アラームが鳴っても誰が何を判断するか決まっていないことがあります。通知が積み上がるうちに現場が見なくなり、定期点検に戻ることもあります。 そのため予知保全AIを選ぶときは、検知精度だけでなくアラーム後の判断と作業指示までの流れを同時に設計します。 異常検知の手法の違いは「異常検知AIとは?手法の比較・導入事例5社と失敗しない進め方」で解説しています。 予知保全AIの導入事例5選|製造・鉄道・電力・プラント 導入事例は、デンカの回転機械、東京メトロの変電所、関西電力の火力発電所、東芝エネルギーシステムズが実証した地熱発電所、大阪ガスリキッドの水素製造装置の5件で、公表された効果は停止・トラブルの件数と検査時間で測られています。 このうちデンカの事例は発表にAIの語がなく、東京メトロは検証の段階です。製造業の工場はデンカの1件ですが、ほかの事例も監視の対象は受変電設備や連続運転する設備なので、工場の同じ種類の設備に置き換えて読めます。 1. デンカ青海工場:回転機械の重大トラブルを年20件から11件へ45%削減 デンカは新潟県の青海工場で、モーターやポンプなど回転機械の状態を無線センサで継続的に監視しています。導入前は時間基準と事後保全が中心で、設備の状態を連続して見られないことが突発停止の原因でした。 ABBの発表にAIの語はなく、センサで集めた振動などのデータを分析して異常の兆候を捉える予知保全の例です。防爆認証のある無線センサを既存設備に後付けして配線工事を避け、監視対象は2022年の試験導入8台から2026年時点で277台に広がりました。 ライン全体を止める重大トラブルは、導入前の年20件から2025年は11件に減りました。監視対象設備では計画外停止の約90%を防いだとされています。 11件のうち監視対象の設備で起きたのは1件だけです。効果は監視している設備に表れることを示しており、対象を段階的に広げる判断の根拠になります。 2. 東京メトロ:変電所の保守をCBM化し、検査時間を最大60%程度削減する見込み 東京メトロは2026年5月、鉄道変電所・電気室の保守を遠隔化・CBM化すると発表しました。背景には、人手による定期の現地検査を続けにくくなっている事情があります。映像・温湿度・部分放電(=絶縁劣化で起きる微小な放電)などをセンサで集め、AIで予兆を分析します。 2026年度は千代田線代々木変電所の周辺を重点地域として各種検証を進め、現地作業と移動の削減で検査時間を最大60%程度短縮する見込みです。工場でいえば、離れた受変電設備の巡回点検にかかる時間です。 3. 関西電力:火力発電所4か所で異常予兆検知システムが稼働 関西電力とアズビルは、大規模プロセスへのAI導入で構築・維持管理の手間と機器の多様さを課題に挙げ、2021年9月に共同開発を始めました。 2023年6月に、異常予兆検知システム「BiG EYES」の拡張ソフトで、火力発電の運用ノウハウを集約した「BiG EYES plus」の販売開始と業務提携を発表しました。 関西電力は、運転データを常時監視する「BiG EYES」を火力発電所4か所に導入し、2025年1月から稼働させています。効果の数字は公表されていません。 4. 東芝エネルギーシステムズ(NEDO事業):地熱発電所のトラブル発生率を20%以上抑制 地熱発電は、設備の老朽化やスケール(=蒸気の成分が固まった付着物)の除去で停止が多い電源です。東芝エネルギーシステムズはNEDO事業として、インドネシアのパトハ地熱発電所で運転データを解析する予兆診断システムを2019年10月から2021年2月まで実証しました。 実証では、過去のトラブル事例に当てはめた評価で、トラブル発生率を20%以上抑制できることを確認し、2022年7月に有償サービスとして実用化されました。稼働後の実測ではなく、過去の停止を何件事前に捉えられたかにあたる数字です。 5. 大阪ガスリキッド:水素製造装置8か所14台に正常データ学習型の予兆検知を導入 大阪ガスリキッドは2020年4月から、水素製造装置「HYSERVE」の8か所14台にAIによる異常予兆検知を導入しています(宇部情報システム・大阪ガスとの共同発表)。 特徴は、トラブル時のデータではなく正常時の運転データだけで学習する方式です。故障の実例が少ない設備でも始められ、利用者が自ら再学習(=新しいデータでAIを学習し直すこと)できます。効果の数字は公表されていません。 5件のうち効果の数字が公表されているのは、次の3件です。 事例指標公表された数字デンカ回転機械の重大トラブル件数年20件から11件(45%減)東京メトロ変電所・電気室の検査時間最大60%程度の削減見込み東芝エネルギーシステムズ地熱発電所のトラブル発生率20%以上抑制できることを確認 対象設備も測り方も異なるため、自社の目標値にそのまま置き換えることはできません。導入前の停止件数や点検時間を先に実測しておくことが、効果を示す前提です。 参照元:ABB株式会社「重大トラブルを45%削減:デンカ社がデータを最も強力な保全ツールへと転換した方法」(2026年10月)/東京メトロ「鉄道変電所・電気室の保守を遠隔化・CBM化します」(2026年5月)/アズビル株式会社「BiG EYESを関西電力の火力発電所4カ所に納入」(2025年6月)、「関西電力との業務提携に合意」(2023年6月)/NEDO「地熱発電所のトラブル発生率を20%以上抑制した予兆診断システムを完成」(2022年8月)/宇部情報システム「AIによる異常予兆検知システムの開発」(2022年3月) 予知保全に必要なデータとセンサ 予知保全に必要なのは、劣化が最初に表れる物理量と、運転条件・保全履歴のデータです。この物理量は設備で異なるため、まず設備ごとに「どこに兆候が出るか」を調べます。たとえば軸受は、傷がつくと回転のたびに傷が当たり、振動の出方が変わります。 データ分かること向く設備の例振動軸受の損傷、アンバランス、芯ずれモーター、ポンプ、減速機温度過熱、潤滑不良、接触不良軸受、電気設備、制御盤電流負荷の変化、駆動部の異常モーター駆動の搬送設備音・超音波漏れ、摩擦、放電配管、バルブ、受変電設備運転データ(圧力・流量など)運転状態のずれプラント、発電設備保全履歴過去の故障と処置全設備(判断ルールの根拠) プラントや発電所では、制御システムに蓄積済みの運転データから始められる場合があります。単体の回転機械は、センサの後付けが必要になりやすい設備です。 現場でよくある問題は、故障時のデータと保全記録がひも付いていないことです。部品交換の記録が紙の点検表にしか残っていないと、兆候と故障の関係を後から確かめられません。 故障の実例が少ない設備では、正常データで学習する異常検知から始めるのが向いています。検知後の点検結果を記録として積み上げるほど、診断や残り寿命の見積もりへ進む材料がそろいます。 製造現場のデータ活用の全体像は「製造業のAI・生成AI活用事例|失敗しない導入とROIの考え方」で整理しています。 予知保全AIの始め方|小さく試す3ステップ 予知保全AIは、1種類の設備と1つの判断ルールから小さく始めるのが進めやすい方法です。全設備を一度に対象にすると、センサ費用とアラーム対応の負荷が先に膨らみ、効果が見える前に運用が止まりやすくなります。 次の3ステップは、事例を踏まえて弊社が勧める進め方です。対象を決めないと検証の合格条件も決まらないため、この順に進めます。 ステップ1. 停止損失が大きく、兆候を測れる設備を選ぶ 対象は、止まったときの損失が大きく、兆候を測れる設備から選びます。損失が小さいと費用を回収しにくく、兆候を測れないと検知できないためです。 この絞り込みを飛ばして広く始めると、どの設備で効果が出たのかを説明できず、次の投資判断ができなくなります。候補が複数あれば、突発停止で生産を止めた回数の多い設備を優先します。 ステップ2. 導入前の停止件数と点検時間を実測し、合格条件を決める 過去の記録から計画外停止の件数・停止時間・点検時間を集計し、PoC(=本番開発の前に小さく行う技術検証)の合格条件を数値で決めます。導入前の値が無いと、件数が減っても効果を示せません。 合格条件には検知精度だけでなく、停止の何日前に検知できれば計画に組み込めるかという業務側の条件も入れます。直前の検知では、部品の手配や計画停止に間に合わないためです。 感度を上げると見逃しは減りますが誤報が増え、誤報が続くと現場は通知を見なくなります。そのため「見逃してはいけない故障」と「許容できる誤報の頻度」を、保全担当者と先に決めておきます。 指標の決め方は「PoC評価指標の決め方|成功基準・KPI例と3層モデル2026」で解説しています。 ステップ3. アラーム後の判断と作業指示までを運用に組み込む 検知の通知を誰が受け、どの基準で点検・停止を決め、結果をどこに記録するかを決めます。現場で再学習できる仕組みにしておくと、設備の更新や運転条件の変化にも追随できます。 担当と基準が無いと、夜間の通知で設備を止める判断ができません。検証の期間中から、保全担当者が実際の通知で判断する場を設けることをおすすめします。 予知保全は設備データでの小さな検証から始めるのが近道だと弊社は考えています。この検証を支援するため、AI PoCサービス「ココロミ」(スリムプラン月々99万円〜・スタンダードプラン月々250万円〜)を提供しています。 Cyto-Factoとの取り組みでは、製造現場の機器画面をAI-OCRで読み取って記録を自動化する仕組みの開発を進めており、サンプル画像では認識精度100%を達成しています。センサを後付けしにくい設備でも、表示値をデータとして集める方法があります。 参照元:株式会社EQUES「Cyto-Facto 導入事例」 ココロミ の詳細はこちら 予知保全AIに関するよくある質問 Q. 故障データがほとんど無い設備でも予知保全は始められますか? 始められます。正常時の運転データだけで学習し、外れた状態を兆候として捉える方式があり、大阪ガスリキッドの事例もこの方式です。 Q. 予知保全を導入すれば、定期点検はなくせますか? すべてはなくせません。法定点検は時間基準で続け、予知保全では自主的に決めている点検周期や部品の交換時期を見直します。 Q. パッケージ製品と個別開発のどちらを選ぶべきですか? 汎用の回転機械はセンサと分析がセットのパッケージで始めやすく、独自の装置や、複数の運転データを組み合わせて判断する設備は個別開発が必要になる場合があります。 まとめ 本記事の要点は次のとおりです。 予知保全は状態データで保全時期を決める運用で、異常検知はその手段の一つにあたる 公表事例の効果は停止・トラブル件数や検査時間で示され、デンカは回転機械の重大トラブルを45%減らした 停止損失の大きい設備を1種類選び、導入前の値の実測と検知後の運用設計から小さく始める 自社設備のデータで予知保全を試せるか確かめたい段階でも、お気軽にご相談ください。最後までお読みいただき、ありがとうございました。 設備データでの予知保全を、小さく検証しませんか AI PoCサービス「ココロミ」はスリムプラン月々99万円〜・スタンダードプラン月々250万円〜の月額制です。まずは無料相談からどうぞ。 無料で相談する ココロミを見る

View All
採用情報